КОГДА СХОДЯТСЯ ЗВЕЗДЫ
Анатолий Большаков
руководитель лаборатории технологий ИИ аналитического центра кибербезопасности ООО «Газинформсервис», к. т. н.
ИИ в SOC:
от перегрузки алертами к автономным агентам и парадигме Machine-to-Machine
Алексей Лукашин
доцент Высшей школы технологий ИИ Санкт-Петербургского политехнического университета Петра Великого, к. т. н.
Применение машинного обучения в центрах мониторинга (SOC) нельзя рассматривать как простую адаптацию решений, уже отработанных в корпоративных службах ИТ-поддержки (ITSM/helpdesk).
Несмотря на внешнее сходство — и там, и там аналитик обрабатывает поток входящих тикетов, операционная среда SOC обладает принципиально иной природой. Отметим следующие значительные отличия SOC:
Интенсивность и неравномерность потока
Helpdesk получает, как правило, равномерный поток обращений, поддающийся прогнозированию и нормированию.
SOC работает в условиях резких пиков: во время активной атаки объем алертов может возрастать на порядки за считаные минуты, а SIEM способен генерировать тысячи событий в секунду.
Асимметрия цены ошибки
В ИТ-поддержке пропущенный тикет означает задержку обслуживания.
В SOC пропущенный инцидент — это потенциально скомпрометированная инфраструктура, утечка данных или остановка производства. Стоимость ошибки может оказаться очень высокой.
Автоматизация на стороне атакующего
ИТ-инциденты в большинстве своем инициируются людьми или детерминированными сбоями.
Кибератаки 2025−2026 годов все чаще являются машинно-генерируемыми: автоматизированные фреймворки сканируют периметр, эксплуатируют уязвимости и адаптируют тактику в реальном времени без участия человека. Это выдвигает требования к скорости реагирования на инциденты.
Контекстная зависимость и нелинейность
Тикет в helpdesk, как правило, самодостаточен, например «не работает принтер».
Алерт в SOC почти всегда требует корреляции с десятками других событий во времени и пространстве инфраструктуры — один и тот же сетевой запрос может быть нормой или признаком горизонтального распространения в зависимости от того, что происходило за последние 72 часа.
При этом анализ данных аналитиком SOC производится в различных средствах защиты информации, которые могут быть не интегрированы друг с другом или интегрированы только через SIEM, что приводит к большому количеству ручной работы и высокой вероятности ошибки.
При этом анализ данных аналитиком SOC производится в различных средствах защиты информации, которые могут быть не интегрированы друг с другом или интегрированы только через SIEM, что приводит к большому количеству ручной работы и высокой вероятности ошибки.
Дефицит размеченных данных
Helpdesk накапливает размеченную историю органически: каждый закрытый тикет — это обучающий пример.
В SOC реальные инциденты — редкость на фоне миллионов событий, а их разметка требует экспертизы. Проблема дисбаланса классов здесь критична: соотношение «норма/атака» может составлять 10 000:1 и более.
Чувствительность размеченных данных
Данные SOC содержат информацию об инфраструктуре, что делает сложным их очистку, и в большинстве случаев публичная публикация таких наборов данных невозможна.
Таким образом, SOC является отличным кандидатом для применения ИИ, и автоматизация анализа данных и принятия решения становится не просто важной, а необходимой. Но в то же время вышеперечисленные особенности создают новые вызовы к ИИ-системам и формулируют требования, которые обеспечить непросто.
В 2026 году завышенные ожидания от применения ИИ в SOC, перегруженных алертами ложноположительных срабатываний, сменяются прагматичной оценкой возврата инвестиций (ROI).
Эта трансформация обусловлена объективными реалиями:
- Кадровый голод и выгораниеДефицит кадров остается главным тормозом отрасли. С нехваткой ИБ-специалистов сталкивается подавляющее большинство российских компаний. При этом главной причиной профессионального выгорания аналитиков является именно рутинная перегрузка.
- Эволюция анатомии ИИ-атакСитуация усугубляется на стороне атакующих, которые уже живут в парадигме Machine-to-Machine (M2M). ИИ-инструменты способны за ночь сгенерировать тысячи векторов атак, автономно применять эксплойты и адаптироваться под средства защиты на лету. Ответить на машинно-генерируемые атаки усилиями уставших людей больше невозможно.
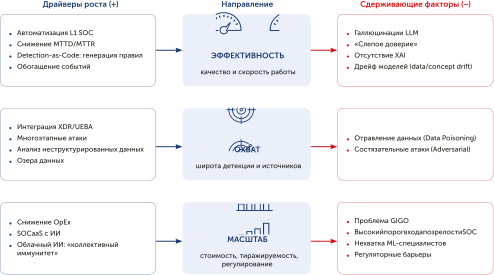
Замена рутины алгоритмами машинного обучения теперь вопрос выживания. Однако внедрение ИИ сопряжено с новыми рисками: от необъяснимых решений моделей до уязвимости самих алгоритмов. Оценить перспективы и барьеры внедрения ИИ в контуре мониторинга можно через три направления (рис. 1): эффективность, охват и масштаб.
Рисунок 1. Направления развития ИИ в SOC
[качество и скорость работы]
Эффективность
Драйверы роста (+)
В передовых SOC ИИ уже сегодня берет на себя первичную сортировку инцидентов (первая линия), снижая количество ложных срабатываний на десятки процентов.
По нашим оценкам, использование ИИ сокращает обработку алерта (подозрения на инцидент) на 5−15 минут и дает экономию 640 часов экспертного времени аналитиков SOC при потоке 4500 алертов в месяц. В логике Detection-as-Code алгоритмы способны генерировать черновики правил корреляции, существенно ускоряя инженерию обнаружения и снижая среднее время обнаружения (MTTD) и реагирования (MTTR).
Сдерживающие факторы (–)
Главная проблема — «слепое доверие». Большие языковые модели (LLM) подвержены галлюцинациям.
Отсутствие объяснимости (XAI) превращает ИИ в «черный ящик», недопустимый для критичных инфраструктур ⓘ. Кроме того, со временем возникает дрейф моделей (data drift, concept drift), ведущий к деградации защиты.
К. Мушовец. Искусственный интеллект в SOC: помощь аналитикам и прогноз на ближайший год // Альманах «ИБ-пророк», 2024. Подробнее
[широта обнаружения и источников]
Охват
Драйверы роста (+)
Интеграция ИИ с XDR-платформами позволяет выявлять сложные многоэтапные атаки.
Чтобы ИИ в SOC научился выявлять многоэтапные атаки, он должен тренироваться на киберполигонах с синтетическими сценариями, неотличимыми от реальности ⓘ. Поведенческая аналитика (UEBA) обнаруживает аномалии учетных записей и горизонтальное перемещение, незаметное для сигнатур. ИИ работает с озерами данных, парсит неструктурированные логи и тексты, расширяя поверхность мониторинга.
Отметим, что роль киберполигонов в совершенствовании систем обеспечения безопасности раскрыта в статьях А. Мартынцева и Н. Нашивочникова в выпуске альманаха 2025 г.:
Сдерживающие факторы (–)
Сами AI/ML-модели становятся объектом атак.
Отравление данных (data poisoning) или состязательные атаки (adversarial attacks) заставляют модель ошибаться при сохранении видимой нормальности поведения системы. Как подчеркивалось в статье А. Чечулина, ИИ — это не только инструмент защиты, но и объект защиты, и этот фактор ранее зачастую недооценивался ⓘ.
А. Чечулин. ИИ в кибербезопасности: инструмент, помощник, противник // Альманах «ИБ-пророк», 2025. Подробнее
[стоимость, тиражируемость, регулирование]
Масштаб
Драйверы роста (+)
Снижаются операционные расходы.
Появляются доступные сервисные модели (SOCaaS с ИИ). Облачные ИИ-сервисы формируют «коллективный иммунитет», обучаясь на инцидентах десятков организаций.
Сдерживающие факторы (–)
ИИ требует высокой зрелости процессов. Правило GIGO (Garbage In, Garbage Out) работает безотказно: если данные не нормализованы, инциденты не размечены, а инфраструктура высоко динамична, ИИ лишь ускорит генерацию ошибочных выводов.
Порог входа остается высоким: нужны аналитики и инженеры данных, ML-специалисты, инфраструктура для обучения и мониторинга. Наконец, регуляторы начинают предъявлять требования к ИИ-системам, используемым в КИИ, что создает дополнительные барьеры. Важнейший тезис современного этапа: ИИ не заменяет зрелость SOC, а лишь обнажает ее отсутствие.
Приказ ФСТЭК России № 117 задает требования к инвентаризации и контролю конфигураций ⓘ. Для ИИ в SOC это означает: модель должна быть учтена как актив, любые изменения версионированы, для каждой версии должны быть получены утвержденные метрики и проведено тестирование работы модели в реальной системе: модели, обученные на личных ноутбуках аналитиков, уходят в прошлое. Говоря о регуляторном управлении, отметим, что в 2026 году ФСТЭК России впервые прямо определила требования к защите информации в ИИ-системах.
Среди них: выделение инфраструктуры разработки ИИ в изолированные сегменты, криптографический контроль целостности параметров (весов) моделей (в качестве замены небезопасным форматам хранения, таким как pickle), а также обязательная фильтрация входных запросов и тестирование на устойчивость к промпт-атакам. Для SOC это означает обязательную сертификацию ИИ-компонентов и внедрение доверенного производственного MLOps-конвейера. Исходя из опыта внутренних исследовательских проектов, реализация такого конвейера потребует решения ряда задач обеспечивающего характера.
Л. Виткова. Безопасность И И: настоящее и будущее новых продуктов в ИБ // Альманах «ИБ-пророк», 2025. Подробнее
- Разделение контуров (испытательный полигон)Обучение моделей, симуляция многовекторных атак и фоновой нагрузки (в том числе с помощью автоматизации действий пользователей и атакующих, RPA) проводятся в строго изолированном полигоне (рис. 2).
- Мониторинг дрейфа и XAIВ продуктиве отслеживается изменение статистических свойств данных, а для каждого инцидента формируется объяснение принятого моделью решения, понятное аналитику.
- Верификация перед инференсомПеред загрузкой модели в оперативную память криптографически верифицируется ее подпись.
- Безопасная упаковкаИсполняемые форматы упаковываются в неизменяемый артефакт и подписываются сертифицированной в РФ электронной подписью.
Рисунок 2. Доверенный MLOps-конвейер
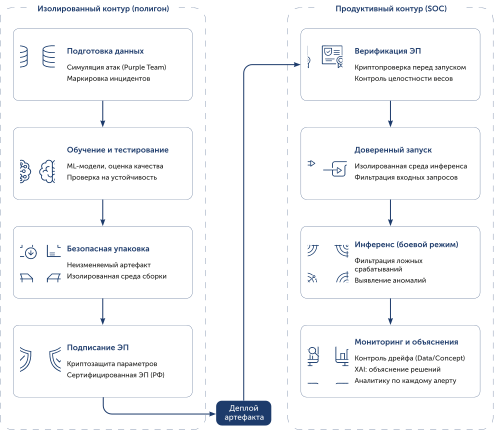
Обратная связь: результаты продуктива → дообучение модели
ФСТЭК-2026: изоляция, криптоконтроль весов, XAI, защита от промпт-атак.
ФСТЭК-2026: изоляция, криптоконтроль весов, XAI, защита от промпт-атак.
Ответом на вызов, обусловленный невозможностью публикации датасетов для разработки новых моделей машинного обучения, является федеративное обучение (Federated Learning, FL). На сегодняшний день традиционная модель обмена threat intelligence предполагает передачу индикаторов компрометации (IoC) — хешей, IP-адресов, сигнатур.
Но сегодня IoC устаревают за часы, а поведенческие паттерны сложных атак в них не укладываются. Обучение моделей на таких данных затруднено. FL предлагает новый подход: SOC разных организаций совместно улучшают общую модель обнаружения, не передавая друг другу сырые логи и данные об инцидентах.
Но сегодня IoC устаревают за часы, а поведенческие паттерны сложных атак в них не укладываются. Обучение моделей на таких данных затруднено. FL предлагает новый подход: SOC разных организаций совместно улучшают общую модель обнаружения, не передавая друг другу сырые логи и данные об инцидентах.
Каждый участник обучает модель локально на своих данных, после чего в общий репозиторий отправляются только градиенты — математические производные, описывающие направление улучшения модели, но не содержащие исходных событий. Центральный сервер агрегирует обновления (например, методом FedAvg) и рассылает улучшенную модель обратно. Применимость этого подхода непосредственно в контексте SOC подтверждена экспериментально: совместное обучение без обмена данными повышает качество обнаружения на 8−15% по сравнению с изолированными моделями, причем малые участники получают наибольший выигрыш за счет экспертизы более крупных ⓘ.
E. Khramtsova, C. Hammerschmidt, S. State, R. State. Federated Learning For Cyber Security: SOC Collaboration For Malicious URL Detection // IEEE ICASSP 2021. Подробнее
Для российского контекста это особенно актуально: такая архитектура позволяет организациям — субъектам КИИ — совместно обучать модели обнаружения угроз в рамках отраслевых объединений (энергетика, финансы, транспорт), не нарушая требований 187-ФЗ и не раскрывая сведений об инцидентах регулятору или партнерам. Данные физически не покидают инфраструктуру владельца.
Практические барьеры, однако, существенны. Во-первых, нужна единая онтология событий: если один участник пишет логи в CEF, другой — в LEEF, а третий — в собственном формате, градиенты окажутся несовместимы. Во-вторых, сама схема FL не абсолютно защищена: атаки на агрегацию (gradient inversion, Byzantine poisoning) позволяют недобросовестному участнику восстановить фрагменты чужих данных или испортить общую модель ⓘ.
Это означает, что доверенный MLOps-конвейер, описанный выше, должен распространяться и на федеративный контур — с верификацией участников и криптографической защитой передаваемых градиентов. В ближайшие годы можно ожидать появления отраслевых FL-хабов — возможно, на базе ГосСОПКА, где модели будут дообучаться на коллективном опыте десятков организаций, не создавая единой точки утечки данных.
B. Gosselin et al. Federated Learning for Cybersecurity: A Privacy-Preserving Approach // Applied Sciences, MDPI, Vol. 15, No. 12, 2025. Подробнее
Опираясь на анализ направлений развития и наш практический опыт применения ИИ в SOC, можно сделать следующие прогнозы:
В 2026–2027 годах:
- ИИ становится штатным аналитиком первой линии в большинстве крупных SOC. Полностью автоматизируется фильтрация ложных срабатываний по известным паттернам, обогащение событий контекстом, первичная приоритизация. Уровень доверия к вердиктам ИИ останется ограниченным.
- Ключевой проблемой останется нехватка специалистов, сочетающих экспертизу в ИБ и машинном обучении. Компании будут вынуждены либо развивать внутренние компетенции, либо полагаться на аутсорсинг (SOCaaS с ИИ), доля которого превысит 40% новых внедрений.
- Появятся модули для SIEM/XDR, удовлетворяющие требованиям ФСТЭК к ИИ-системам (безопасность моделей, объяснимость, защита от состязательных атак).
К 2028 году:
- Совершается качественный переход к архитектуре агентного SOC (Agentic SOC). Вместо статичных плейбуков SOAR внедряются автономные агенты. Они получают ограниченное право на автономное реагирование, например, изоляцию хоста в рамках строгих политик.
- Появляются отраслевые стандарты федеративного обучения и «цифровые двойники» ⓘ инфраструктуры для безопасной симуляции атак.
Симуляционные среды (испытательные полигоны), в которых ИИ-агенты обучаются отражать атаки без риска для реальной инфраструктуры. Это позволит ускорить внедрение новых моделей и сократить время их валидации.
Ключевой вывод заключается в следующем: ИИ в SOC — это не полная замена человека, а инструмент, требующий новой культуры доверия, контроля и постоянного аудита.
В ближайшие годы доминирующей останется парадигма SOC с участием человека (Human-Augmented SOC). Роль аналитика окончательно сместится от классического «разборщика алертов» к «супервизору ИИ». К 2028 году SOC без встроенных ИИ-компонентов будет восприниматься так же архаично, как сегодняшний SOC без SIEM. Однако «массового результата» в ближайшие один-три года не ожидается. Инвестиции в MLOps, сертификацию и переобучение персонала требуют времени.
Те, кто начнет в 2026 году, получат преимущество к 2028-му. Те, кто ждет «готового продукта из коробки», рискуют оказаться в роли аутсайдера. Вопрос не в том, внедрять ли ИИ, а в том, как внедрить его ответственно, с соблюдением регуляторных требований и сохранением контроля со стороны человека, выстроить зрелые процессы, при которых ИИ будет защищать инфраструктуру, а не масштабировать операционный хаос.